# ViTMAE
[ViTMAE](https://huggingface.co/papers/2111.06377) adalah model visi self-supervised yang dilatih awal dengan menutupi sebagian besar gambar (~75%). Encoder memproses patch gambar yang terlihat, dan decoder merekonstruksi piksel yang hilang dari patch yang telah di-encode dan token mask. Setelah pelatihan awal, encoder dapat digunakan kembali untuk tugas turunan seperti klasifikasi gambar atau deteksi objek — sering kali melampaui model yang dilatih dengan pembelajaran terawasi.
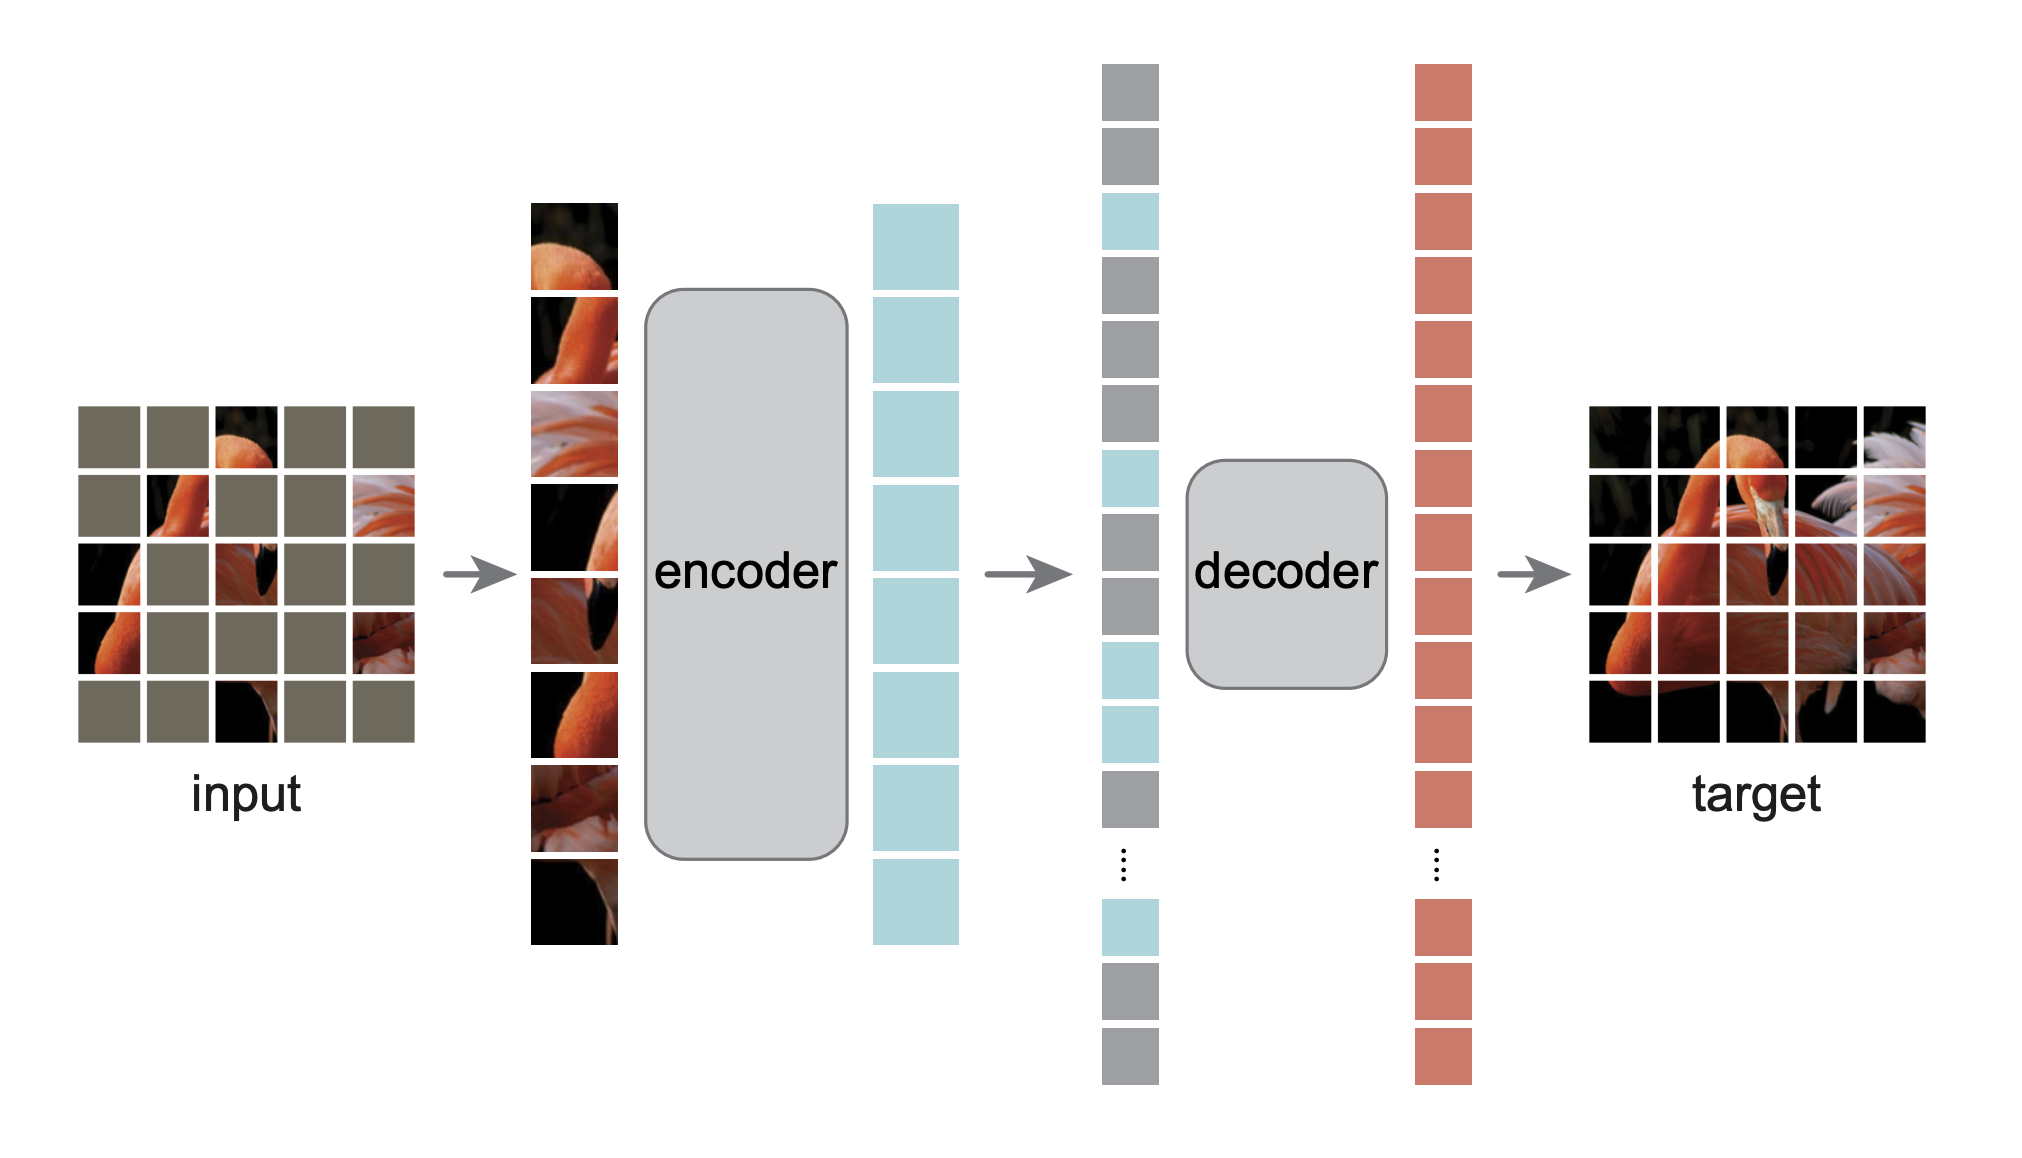 Anda dapat menemukan semua checkpoint ViTMAE asli di bawah organisasi [AI at Meta](https://huggingface.co/facebook?search_models=vit-mae).
> [!TIP]
> Klik model ViTMAE di bilah sisi kanan untuk melihat lebih banyak contoh cara menerapkan ViTMAE ke tugas visi.
Contoh di bawah ini menunjukkan cara merekonstruksi piksel yang hilang dengan kelas [ViTMAEForPreTraining](/docs/transformers/main/id/model_doc/vit_mae#transformers.ViTMAEForPreTraining).
```python
import requests
import torch
from PIL import Image
from transformers import ViTImageProcessor, ViTMAEForPreTraining
url = "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/pipeline-cat-chonk.jpeg"
image = Image.open(requests.get(url, stream=True).raw)
processor = ViTImageProcessor.from_pretrained("facebook/vit-mae-base")
inputs = processor(image, return_tensors="pt").to(model.device)
inputs = {k: v.to(model.device) for k, v in inputs.items()}
model = ViTMAEForPreTraining.from_pretrained("facebook/vit-mae-base", attn_implementation="sdpa", device_map="auto")
with torch.no_grad():
outputs = model(**inputs)
reconstruction = outputs.logits
```
## Catatan
- ViTMAE biasanya digunakan dalam dua tahap. Pra-pelatihan tanpa pengawasan dengan [ViTMAEForPreTraining](/docs/transformers/main/id/model_doc/vit_mae#transformers.ViTMAEForPreTraining), kemudian membuang decoder dan melakukan fine-tuning pada encoder. Setelah fine-tuning, bobotnya dapat dimasukkan ke dalam model seperti [ViTForImageClassification](/docs/transformers/main/id/model_doc/vit#transformers.ViTForImageClassification).
- Gunakan [ViTImageProcessor](/docs/transformers/main/id/model_doc/vit#transformers.ViTImageProcessor) untuk persiapan input.
## Sumber daya
- Lihat [notebook](https://github.com/NielsRogge/Transformers-Tutorials/blob/master/ViTMAE/ViT_MAE_visualization_demo.ipynb) ini untuk mempelajari cara memvisualisasikan piksel yang direkonstruksi dari [ViTMAEForPreTraining](/docs/transformers/main/id/model_doc/vit_mae#transformers.ViTMAEForPreTraining).
## ViTMAEConfig[[transformers.ViTMAEConfig]]
#### transformers.ViTMAEConfig[[transformers.ViTMAEConfig]]
```python
transformers.ViTMAEConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 768, num_hidden_layers: int = 12, num_attention_heads: int = 12, intermediate_size: int = 3072, hidden_act: str = 'gelu', hidden_dropout_prob: float | int = 0.0, attention_probs_dropout_prob: float | int = 0.0, initializer_range: float = 0.02, layer_norm_eps: float = 1e-12, image_size: int | list[int] | tuple[int, int] = 224, patch_size: int | list[int] | tuple[int, int] = 16, num_channels: int = 3, qkv_bias: bool = True, decoder_num_attention_heads: int = 16, decoder_hidden_size: int = 512, decoder_num_hidden_layers: int = 8, decoder_intermediate_size: int = 2048, mask_ratio: float = 0.75, norm_pix_loss: bool = False)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vit_mae/configuration_vit_mae.py#L24)
**Parameter:**
hidden_size (`int`, *opsional*, defaultnya `768`) : Dimensi dari representasi tersembunyi.
num_hidden_layers (`int`, *opsional*, defaultnya `12`) : Jumlah lapisan tersembunyi dalam decoder Transformer.
num_attention_heads (`int`, *opsional*, defaultnya `12`) : Jumlah kepala perhatian untuk setiap lapisan perhatian dalam decoder Transformer.
intermediate_size (`int`, *opsional*, defaultnya `3072`) : Dimensi dari representasi MLP.
hidden_act (`str`, *opsional*, defaultnya `gelu`) : Fungsi aktivasi non-linear (fungsi atau string) di decoder. Misalnya, `"gelu"`, `"relu"`, `"silu"`, dan sebagainya.
hidden_dropout_prob (`Union[float, int]`, *opsional*, defaultnya `0.0`) : Probabilitas dropout untuk semua lapisan fully connected di embeddings, encoder, dan pooler.
attention_probs_dropout_prob (`Union[float, int]`, *opsional*, defaultnya `0.0`) : Rasio dropout untuk probabilitas perhatian.
initializer_range (`float`, *opsional*, defaultnya `0.02`) : Deviasi standar dari truncated_normal_initializer untuk menginisialisasi semua matriks bobot.
layer_norm_eps (`float`, *opsional*, defaultnya `1e-12`) : Epsilon yang digunakan oleh lapisan normalisasi lapisan.
image_size (`Union[int, list[int], tuple[int, int]]`, *opsional*, defaultnya `224`) : Ukuran (resolusi) dari setiap gambar.
patch_size (`Union[int, list[int], tuple[int, int]]`, *opsional*, defaultnya `16`) : Ukuran (resolusi) dari setiap patch.
num_channels (`int`, *opsional*, default `3`) : Jumlah saluran input.
qkv_bias (`bool`, *opsional*, defaultnya `True`) : Apakah akan menambahkan bias ke queries, keys, dan values.
decoder_num_attention_heads (`int`, *opsional*, defaultnya `16`) : Jumlah kepala perhatian untuk setiap lapisan perhatian dalam decoder Transformer.
decoder_hidden_size (`int`, *opsional*, defaultnya `512`) : Dimensi dari representasi tersembunyi.
decoder_num_hidden_layers (`int`, *opsional*, defaultnya 8) : Jumlah lapisan tersembunyi dalam decoder.
decoder_intermediate_size (`int`, *opsional*, defaultnya `2048`) : Dimensi dari representasi MLP.
mask_ratio (`float`, *opsional*, default 0,75) : Rasio jumlah token yang di-mask pada urutan input.
norm_pix_loss (`bool`, *opsional*, default `False`) : Apakah akan melatih dengan piksel ternormalisasi (lihat Tabel 3 di makalah). Penggunaan piksel ternormalisasi meningkatkan kualitas representasi dalam eksperimen para penulis.
Ini adalah kelas konfigurasi untuk menyimpan konfigurasi dari ViTMAEModel. Kelas ini digunakan untuk membuat instans model Vit Mae sesuai dengan argumen yang ditentukan, sehingga mendefinisikan arsitektur model. Membuat instans konfigurasi dengan nilai bawaan akan menghasilkan konfigurasi yang serupa dengan konfigurasi dari [facebook/vit-mae-base](https://huggingface.co/facebook/vit-mae-base)
Objek konfigurasi mewarisi dari [PreTrainedConfig](/docs/transformers/main/id/main_classes/configuration#transformers.PreTrainedConfig) dan dapat digunakan untuk mengontrol keluaran model. Baca dokumentasi dari [PreTrainedConfig](/docs/transformers/main/id/main_classes/configuration#transformers.PreTrainedConfig) untuk informasi lebih lanjut.
Contoh:
```python
>>> from transformers import ViTMAEConfig, ViTMAEModel
>>> # Initializing a ViT MAE vit-mae-base style configuration
>>> configuration = ViTMAEConfig()
>>> # Initializing a model (with random weights) from the vit-mae-base style configuration
>>> model = ViTMAEModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## ViTMAEModel[[transformers.ViTMAEModel]]
#### transformers.ViTMAEModel[[transformers.ViTMAEModel]]
```python
transformers.ViTMAEModel(config: ViTMAEConfig)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vit_mae/modeling_vit_mae.py#L614)
**Parameter:**
config ([ViTMAEConfig](/docs/transformers/main/id/model_doc/vit_mae#transformers.ViTMAEConfig)) : Konfigurasi untuk model.
Model Vit Mae polos yang menghasilkan hidden-states mentah tanpa head spesifik di atasnya.
Model ini mewarisi dari [PreTrainedModel](/docs/transformers/main/id/main_classes/model#transformers.PreTrainedModel). Periksa dokumentasi kelas induk untuk metode generik yang diimplementasikan oleh pustaka ini untuk semua model (seperti mengunduh atau menyimpan, mengubah ukuran input embeddings, memangkas heads, dll.)
Model ini juga merupakan subclass dari [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) PyTorch. Gunakan sebagai PyTorch Module biasa dan merujuk ke dokumentasi PyTorch untuk semua hal yang berkaitan dengan penggunaan dan perilaku umum.
#### forward[[transformers.ViTMAEModel.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, noise: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool | None = None, attention_mask: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vit_mae/modeling_vit_mae.py#L628)
**Parameter:**
pixel_values (`torch.Tensor` dengan bentuk `(batch_size, num_channels, image_size, image_size)`, *opsional*) : Tensor yang sesuai dengan gambar input. Nilai piksel dapat diperoleh menggunakan [ViTImageProcessor](/docs/transformers/main/id/model_doc/vit#transformers.ViTImageProcessor). Lihat [ViTImageProcessor.__call__()](/docs/transformers/main/id/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) untuk detailnya (`processor_class` menggunakan [ViTImageProcessor](/docs/transformers/main/id/model_doc/vit#transformers.ViTImageProcessor) untuk memproses gambar).
noise (`torch.Tensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Terutama digunakan untuk keperluan pengujian guna mengendalikan keacakan dan menjaga reproduktibilitas
interpolate_pos_encoding (`bool`, *opsional*, default `False`) : Apakah akan menginterpolasi enkoding posisi yang telah dilatih sebelumnya. Ini terutama digunakan untuk memakai model pada gambar dengan resolusi lebih tinggi.
attention_mask (`torch.Tensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Mask untuk menghindari pelaksanaan attention pada indeks token padding. Nilai mask dipilih dalam `[0, 1]`: - 1 untuk token yang **tidak di-mask**, - 0 untuk token yang **di-mask**. [Apa itu attention masks?](../glossary#attention-mask)
**Mengembalikan:** `ViTMAEModelOutput` atau `tuple(torch.Tensor)`
Sebuah `ViTMAEModelOutput` atau tuple dari `torch.Tensor` (jika `return_dict=False` diteruskan atau ketika `config.return_dict=False`) yang terdiri dari berbagai elemen tergantung pada konfigurasi ([ViTMAEConfig](/docs/transformers/main/id/model_doc/vit_mae#transformers.ViTMAEConfig)) dan input.
Metode forward dari [ViTMAEModel](/docs/transformers/main/id/model_doc/vit_mae#transformers.ViTMAEModel) menimpa metode khusus `__call__`.
Meskipun resep untuk forward pass perlu didefinisikan di dalam fungsi ini, sebaiknya panggil instance `Module` setelahnya alih-alih fungsi ini, karena yang pertama menangani langkah-langkah pra-pemrosesan dan pasca-pemrosesan, sedangkan yang kedua mengabaikannya secara diam-diam.
- **last_hidden_state** (`torch.Tensor` dengan bentuk `(batch_size, sequence_length, hidden_size)`, *opsional*) -- Urutan hidden-states pada keluaran dari lapisan terakhir model.
- **mask** (`torch.Tensor` dengan bentuk `(batch_size, sequence_length)`) -- Tensor yang menunjukkan patch mana yang di-mask (1) dan mana yang tidak (0).
- **ids_restore** (`torch.LongTensor` dengan bentuk `(batch_size, sequence_length)`) -- Tensor yang berisi indeks asli dari patch (yang diacak) yang dimasker.
- **hidden_states** (`tuple[torch.Tensor]`, *opsional*, dikembalikan ketika `output_hidden_states=True` dilewatkan atau ketika `config.output_hidden_states=True`) -- Tuple dari `torch.Tensor` (satu untuk output dari embeddings, jika model memiliki lapisan embedding, + satu untuk output dari setiap lapisan) dengan bentuk `(batch_size, sequence_length, hidden_size)`.
Hidden-states model pada output setiap layer ditambah output embedding awal yang opsional.
- **attentions** (`tuple[torch.Tensor]`, *opsional*, dikembalikan ketika `output_attentions=True` dilewatkan atau ketika `config.output_attentions=True`) -- Tuple dari `torch.Tensor` (satu untuk setiap layer) dengan bentuk `(batch_size, num_heads, sequence_length, sequence_length)`.
Bobot perhatian setelah softmax perhatian, digunakan untuk menghitung rata-rata berbobot di kepala self-attention.
Contoh:
```python
>>> from transformers import AutoImageProcessor, ViTMAEModel
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> image_processor = AutoImageProcessor.from_pretrained("facebook/vit-mae-base")
>>> model = ViTMAEModel.from_pretrained("facebook/vit-mae-base")
>>> inputs = image_processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> last_hidden_states = outputs.last_hidden_state
```
## ViTMAEForPreTraining[[transformers.ViTMAEForPreTraining]]
#### transformers.ViTMAEForPreTraining[[transformers.ViTMAEForPreTraining]]
```python
transformers.ViTMAEForPreTraining(config: ViTMAEConfig)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vit_mae/modeling_vit_mae.py#L691)
**Parameter:**
config ([ViTMAEConfig](/docs/transformers/main/id/model_doc/vit_mae#transformers.ViTMAEConfig)) : Kelas konfigurasi model dengan semua parameter model. Inisialisasi dengan file konfigurasi tidak memuat bobot yang terkait dengan model, hanya konfigurasinya. Lihat metode [from_pretrained()](/docs/transformers/main/id/main_classes/model#transformers.PreTrainedModel.from_pretrained) untuk memuat bobot model.
Transformer Model ViTMAE dengan decoder di bagian atas untuk pra-pelatihan tanpa pengawasan diri.
Model ini mewarisi dari [PreTrainedModel](/docs/transformers/main/id/main_classes/model#transformers.PreTrainedModel). Periksa dokumentasi kelas induk untuk metode generik yang diimplementasikan oleh pustaka ini untuk semua model (seperti mengunduh atau menyimpan, mengubah ukuran input embeddings, memangkas heads, dll.)
Model ini juga merupakan subclass dari [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) PyTorch. Gunakan sebagai PyTorch Module biasa dan merujuk ke dokumentasi PyTorch untuk semua hal yang berkaitan dengan penggunaan dan perilaku umum.
#### forward[[transformers.ViTMAEForPreTraining.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, noise: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool | None = None, attention_mask: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vit_mae/modeling_vit_mae.py#L790)
**Parameter:**
pixel_values (`torch.Tensor` dengan bentuk `(batch_size, num_channels, image_size, image_size)`, *opsional*) : Tensor yang sesuai dengan gambar input. Nilai piksel dapat diperoleh menggunakan [ViTImageProcessor](/docs/transformers/main/id/model_doc/vit#transformers.ViTImageProcessor). Lihat [ViTImageProcessor.__call__()](/docs/transformers/main/id/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) untuk detailnya (`processor_class` menggunakan [ViTImageProcessor](/docs/transformers/main/id/model_doc/vit#transformers.ViTImageProcessor) untuk memproses gambar).
noise (`torch.Tensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Terutama digunakan untuk keperluan pengujian guna mengendalikan keacakan dan menjaga reproduktibilitas
interpolate_pos_encoding (`bool`, *opsional*, default `False`) : Apakah akan menginterpolasi enkoding posisi yang telah dilatih sebelumnya. Ini terutama digunakan untuk memakai model pada gambar dengan resolusi lebih tinggi.
attention_mask (`torch.Tensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Mask untuk menghindari pelaksanaan attention pada indeks token padding. Nilai mask dipilih dalam `[0, 1]`: - 1 untuk token yang **tidak di-mask**, - 0 untuk token yang **di-mask**. [Apa itu attention masks?](../glossary#attention-mask)
**Mengembalikan:** `ViTMAEForPreTrainingOutput` atau `tuple(torch.Tensor)`
A `ViTMAEForPreTrainingOutput` atau tuple dari `torch.Tensor` (jika `return_dict=False` diteruskan atau ketika `config.return_dict=False`) yang terdiri dari berbagai elemen tergantung pada konfigurasi ([ViTMAEConfig](/docs/transformers/main/id/model_doc/vit_mae#transformers.ViTMAEConfig)) dan input.
Metode forward dari [ViTMAEForPreTraining](/docs/transformers/main/id/model_doc/vit_mae#transformers.ViTMAEForPreTraining) menimpa metode khusus `__call__`.
Meskipun resep untuk forward pass perlu didefinisikan di dalam fungsi ini, sebaiknya panggil instance `Module` setelahnya alih-alih fungsi ini, karena yang pertama menangani langkah-langkah pra-pemrosesan dan pasca-pemrosesan, sedangkan yang kedua mengabaikannya secara diam-diam.
- **loss** (`torch.Tensor` dengan bentuk `(1,)`) -- Loss rekonstruksi piksel.
- **logits** (`torch.Tensor` dengan bentuk `(batch_size, sequence_length, patch_size ** 2 * num_channels)`) -- Logits rekonstruksi piksel.
- **mask** (`torch.Tensor` dengan bentuk `(batch_size, sequence_length)`) -- Tensor yang menunjukkan patch mana yang di-mask (1) dan mana yang tidak (0).
- **ids_restore** (`torch.LongTensor` dengan bentuk `(batch_size, sequence_length)`) -- Tensor yang berisi indeks asli dari patch (yang diacak) yang dimasker.
- **hidden_states** (`tuple[torch.Tensor]`, *opsional*, dikembalikan ketika `output_hidden_states=True` dilewatkan atau ketika `config.output_hidden_states=True`) -- Tuple dari `torch.Tensor` (satu untuk output dari embeddings, jika model memiliki lapisan embedding, + satu untuk output dari setiap lapisan) dengan bentuk `(batch_size, sequence_length, hidden_size)`.
Hidden-states model pada output setiap layer ditambah output embedding awal yang opsional.
- **attentions** (`tuple[torch.Tensor]`, *opsional*, dikembalikan ketika `output_attentions=True` dilewatkan atau ketika `config.output_attentions=True`) -- Tuple dari `torch.Tensor` (satu untuk setiap layer) dengan bentuk `(batch_size, num_heads, sequence_length, sequence_length)`.
Bobot perhatian setelah softmax perhatian, digunakan untuk menghitung rata-rata berbobot di kepala self-attention.
Contoh:
```python
>>> from transformers import AutoImageProcessor, ViTMAEForPreTraining
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read())).convert("RGB")
>>> image_processor = AutoImageProcessor.from_pretrained("facebook/vit-mae-base")
>>> model = ViTMAEForPreTraining.from_pretrained("facebook/vit-mae-base")
>>> inputs = image_processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> loss = outputs.loss
>>> mask = outputs.mask
>>> ids_restore = outputs.ids_restore
```